怎样让 Codex 在物理世界干活?清华大学联合无问芯穹、正行创新全新开源具身智能体基础设施 RPent,任务加速 7 倍
随着 GPT-6 Astra 开始接受真实机器人操作测试,数字世界的智能体范式正逐渐走向物理世界。同时也把一个问题变得越来越具体:通用大模型,能否成为机器人的「大脑」,让机器人真正完成现实世界中的复杂任务?
但物理世界中的智能体,不仅要「想明白」,还必须「看得见、做得到、反应快」,并且「记得住」。
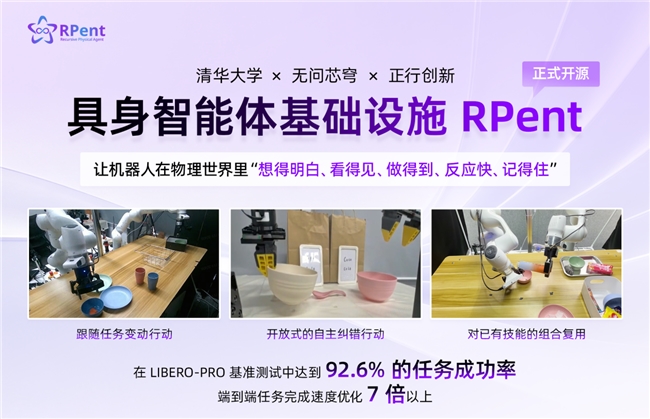
今天,由清华大学、无问芯穹、正行创新联合发起的具身智能体基础设施 RPent 正式开源。RPent 面向真实物理世界,将通用大模型的任务理解与规划能力、VLA 等专家模型的精细操作能力,以及记忆、工具和机器人接口连接起来,形成从感知、决策、执行到反馈纠错的完整闭环,使智能体能够持续适应环境变化,并将经过验证的经验沉淀为可复用的能力,在与物理环境的持续交互中不断学习和进化。在 LIBERO-PRO 基准测试中达到 92.6% 的任务成功率,并将端到端任务完成速度优化 7 倍以上。
RPent 真机效果:从「会动」到「会做事」
此次发布同步释出了一系列 RPent 真机 demo,展示了多个有趣的开放式任务:值得注意的是,这些任务并不是为每一种场景单独训练一个专用策略。机器人真正发生的变化,是开始从「执行学过的动作」,走向「理解任务、调用能力,并根据环境变化调整行动」。
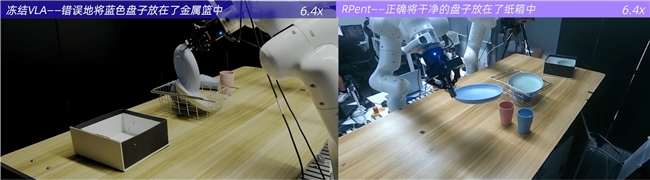
例如,当任务变化为「将干净餐具放入纸箱」时,面对同一只蓝色盘子,冻结 VLA 只会沿用训练时学到的动作,将它错误地放入金属篮中;
而在 RPent 中,智能体会先观察当前环境,再根据新的目标选择放置位置。执行过程中,如果视觉定位出现偏差,它还会检查结果、排除错误目标,并重新定位手中的盘子。任务变了,机器人也能随之改变行动。
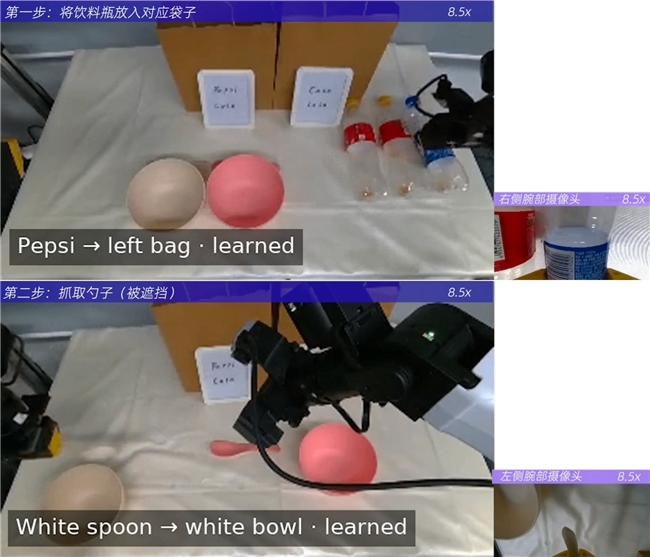
另一个任务中,机器人需要读取瓶身和袋子上的品牌标签,将不同饮料放入对应的袋子。
抓起瓶子后,它会先进行小幅试抬,确认夹持稳定;当原有运动路径不可行时,再调整腕部姿态继续执行。
面对被碗遮挡的勺子,机器人也不会直接尝试抓取,而是先移开两个碗,让目标重新变得可见、可达。
这里展示的已经不再是一条预先写死的动作序列,而是一个完整的「观察—判断—执行—纠错」闭环。
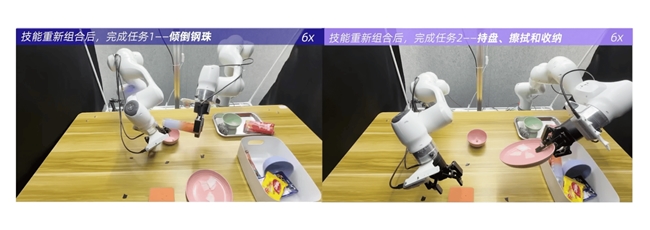
最后两个任务中,机器人可以将原本用于「拿起并放置容器」的技能重新组合,用于倾倒钢珠;又把抓取动作与双臂协同、持续接触组合起来,完成持盘、擦拭和收纳。
探索成功后,RPent 会把经过验证的任务逻辑沉淀为任务卡(Task Card);再次执行时,RPent 可以启用Flash Mode ,通过任务卡直接复用这套流程,只根据当前视觉状态做必要调整,避免每一步都重新调用大模型,有效降低了具身智能体执行的延时。
重要的并不是「机器人又学会了几个动作」,而是「当机器人走向开放世界,新的任务、物体和障碍不断出现时,它能否像人一样将已有技能重新组织起来,完成训练分布之外的任务?」
RPent 所探索的,正是这样的具身智能体形态——机器人不再只是执行一条固定指令,而是能够理解目标、调用能力、应对变化,并将一次成功沉淀为下一次可以复用的经验,这正是具身智能体的雏形。
RPent 核心设计思路:让模型各自承担擅长的事
RPent 不是让某一个模型变得无所不能,包办从任务理解到机械臂控制的全部工作,而是将具身智能拆解为不同层次的能力,让不同模型各自承担最擅长的事情:
○ 通用大模型负责理解任务、制定计划;
○ VLA、WAM 等专家模型负责高精度动作执行;
○ 记忆系统沉淀经验,推动智能体持续优化;
○ 框架负责连接模型、工具与真实环境,形成闭环。
形成「观察—规划—执行—反馈—再规划」的闭环,让智能体从一次性执行任务,走向在真实世界中持续成长。
当智能体走向真实世界,变化的不只是模型能力的边界,也包括支撑这种能力运行的基础设施形态。RPent 所代表的,正是大模型真正走进物理世界之后,需要重新构建的下一层基础设施。
来源:互联网